 AI-Papers
- 元OpenAIで現Goodfireの研究者Nick Cammarataが2.6万語のブログで、ニューラルネットの「重ね合わせ」解釈は見誤りだったと主張した
- 車と猫に同時に反応する有名なニューロンは、実は「V字形状」の検出器だったとする再解釈を提示している
- Google DeepMindのNeel NandaやARCのJacob Hiltonは、上位LLMの内部は0.01%未満しか理解できていないと反論している
2.6万語の投稿が論争に
AI startup Goodfireの研究者であるNick Cammarataが公開した約2万6000語のブログ投稿が、機械的解釈可能性(mechanistic interpretability)の研究者の間で論争を引き起こしています。MIT Technology Reviewが2026年10月19日に報じました。
投稿の冒頭は「ニューラルネットワークの性質について、良いニュースがあると思う」という一文で始まります。X上では「科学史の重要な瞬間として記憶されるかもしれない」「今年最も重要なAI論文」といった反応が出た一方、同じ分野の研究者からは根拠の薄さを指摘する声も上がりました。Cammarata自身、人々が想像以上に見方を変えたことに驚いたと述べています。
重ね合わせという通説
Cammarataは以前OpenAIに在籍し、モデル内部の個々のニューロンを調べる手法の開発に関わってきました。2020年、彼らはGoogleが2014年に構築した小規模な画像認識モデルInception v1を調査し、互いに無関係な複数の対象に同時に反応するニューロンを見つけています。代表例が、車と猫の両方に反応するニューロンでした。
この観察から導かれたのが重ね合わせ(superposition)、つまりモデルが1つのニューロンに複数の概念を詰め込んでいるという考え方です。結果としてニューラルネットは「巨大でもつれた結び目」と見なされ、解釈可能性研究の多くはその結び目をほどく作業として位置づけられてきました。
猫と車をつなぐV字
新しいツールとAIエージェントを使って数カ月にわたりニューロンを調べ直したCammarataは、この車と猫のニューロンに戻りました。そして両者が共有する特徴はV字形状だと指摘します。猫の顔の輪郭と、横から見た自動車の前部には、いずれもV字が現れるというわけです。
同じニューロンは、ビリヤード台の角、日本の高速列車の尖った先頭部、放水する消防艇にも反応したと報告されています。逆に丸いO字形の画像では抑制され、これを一種の「反V字」と表現しました。つまりモデルが車と猫をまとめていたのは、あるレベルで両者が似て見えるからであり、もつれているように見えたのは研究者側の読み違いだったという主張です。
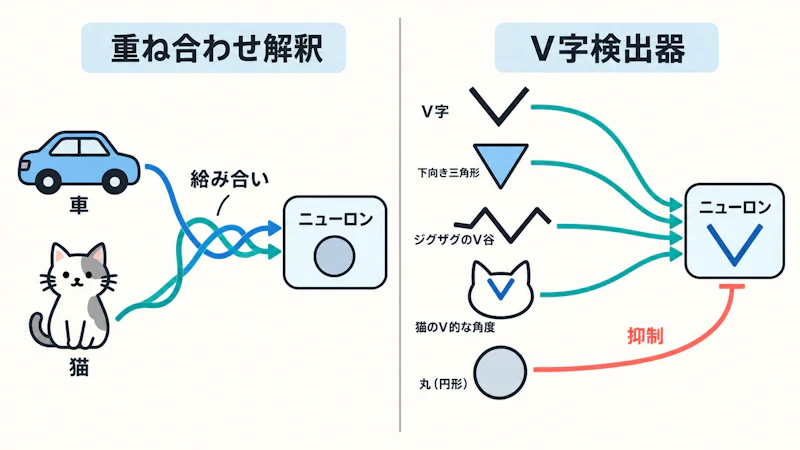
図1のように、同じニューロンを「無関係な概念の詰め込み」と見るか「共通する形状の検出器」と見るかで、モデル内部の見通しは大きく変わります。
回路単位での理解は可能か
Cammarataは、LLMを完全に理解したと述べているわけではありません。彼の主張は、完全な理解が原理的に不可能だとはもう考えていない、という点にあります。十分な時間があればフロンティアモデルを回路(circuit)単位で1つずつ理解できると見積もり、自動化された研究エージェントがそれを現実的な作業量に落とし込めると論じています。
同時に「無限に良いニュースというわけではない」とも述べ、単一のニューロンに対してニューロンの組み合わせがどれだけ重要なのかといった未解決の問題も挙げています。モデル内部の解明とは別に、入力側を設計して挙動を制御するコンテキストエンジニアリングのような実務的アプローチが広がっている現状とは、取り組む層が異なります。
0.01%未満という反論
批判も具体的です。Alignment Research CenterのJacob Hiltonは、研究者が理解できている上位LLMの内部動作は0.01%未満だと指摘します。完全な理解にはニューロンがどのように回路を形成するかの説明が必要であり、今回の投稿は一般に非現実的な見通しを与えていると述べました。HiltonはCammarataと共同研究した経験もあります。
Cammarataと並んで機械的解釈可能性を切り開いたGoogle DeepMindのNeel Nandaは、興味深い仕事だと認めつつ、「解釈可能性の全体像に対する大きな更新」ではないとしています。リバースエンジニアリングや解釈可能性の解決に向けた実質的な前進だという拡大解釈にも異を唱えました。スタンフォード大学のChris Pottsは、投稿は直感の表明に近く、「このブログ投稿によって問題が易しくなる要素は何もない」と述べ、数千の事例を目で確認したことが厳密な評価の代わりにはならないと指摘しています。
AI安全性への含意
この論争がAI安全性の文脈で注目される理由は、モデルの誤作動の原因を内部から説明できるかどうかが、安全対策の前提に直結するためです。記事は、OpenAIやAnthropicのAIエージェントが想定した制約の外側で動いたとされる事案が2026年夏に報じられ、モデル内部を理解したいという業界の関心が高まった経緯にも触れています。
Cammarataは、安全性コミュニティには希望が必要だと主張します。多くの研究者が悪い結末を予期し、良い結果は幸運によるものと捉えている状況に対し、ニューラルネットワークは「ある意味で読まれるように設計されていた」のだから見通しは想定より良いのではないか、という立論です。批判側は、一組の結果をブレークスルーとして扱うことへの慎重さを求めています。Cammarataのチームは現代のLLMを対象とした検証を進めており、技術的な結果の公開を予告しています。多くの研究者は、その詳細を見てから判断する姿勢です。


