 AI-Papers
- 視覚トークンを8個の相補的なコードブックの組で表す、完全離散空間のマルチコードブック拡散言語モデル「Intern Lumina U2」が提案されました
- AToken の統一4D表現を基盤に、画像・動画・3D入力を16B(活性1.4B)のMoE拡散バックボーン1つで扱い、理解・生成・編集を統合しています
- 信頼度プラトーに基づくアンマスクとドリフト検知キャッシュ更新により、画像1枚159.9秒から35.9秒へ、品質を落とさず4.45倍高速化しました
研究の背景
マルチモーダルな大規模言語モデルでは、画像をどう「言語と同じ土俵」に載せるかが設計の分かれ目になります。画像を離散的なトークンに変換する方式(離散トークナイザ)はテキストと同じ予測の枠組みに素直に収まる一方、1つのコードブック(符号の辞書)で表現できる情報量に限りがあり、細部の再現性で不利になります。
逆に連続的な潜在表現を使う方式や両者を混ぜたハイブリッド方式は視覚的な情報を豊かに保てますが、テキストは離散、画像は連続という異なる空間で同時に最適化することになり、学習目的が競合しやすいという問題が残ります。
Intern Lumina U2 は、この二択を離散側に寄せたまま解こうとした研究です。1つの位置に複数のコードを割り当てることで表現容量を増やし、テキストと同じ離散空間で統一的に扱います。論文は、これを完全離散空間でのマルチコードブック表現を採用した最初の拡散言語モデルだと位置づけています。
マルチコードブック離散表現
視覚入力の符号化には AToken を凍結して用います。SigLIP2 から初期化され、再構成と理解の両方で学習されたトークナイザで、画像・動画・3Dアセットを共通の4D潜在空間に写します。量子化は有限スカラー量子化(FSQ)で、コードブック数は8、各コードブックは4096エントリを持ちます。つまり視覚の1位置が8個のコードで表されます。
バックボーンは LLaDA2.0-mini を改変したマスク拡散言語モデルで、総パラメータ16B、トークンあたり活性1.4Bです。20層のうち1層が密結合、残り19層が256個のルーティング専門家と1個の共有専門家を持つMoE層で、トークンごとに8専門家が動きます。視覚の入出力インターフェースの追加分は0.65Bです。
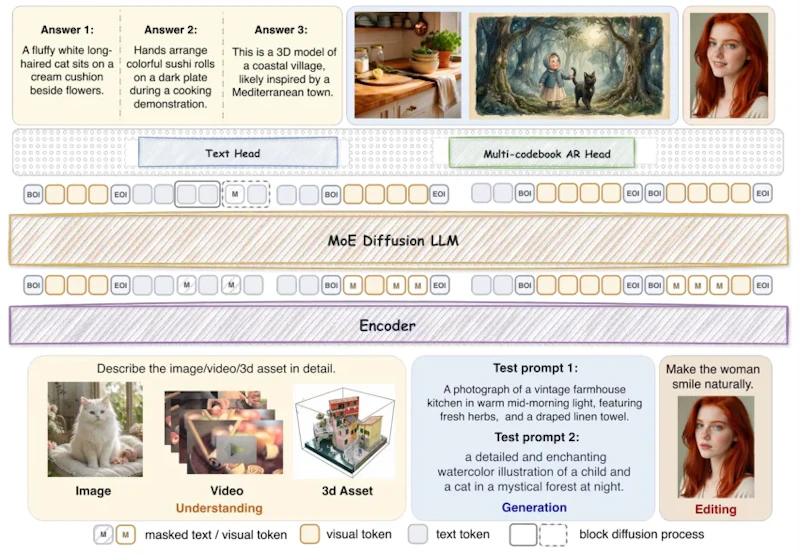
図3のように、テキストのマスクトークンはテキストヘッドがブロック拡散で復元し、視覚のマスクトークンは軽量な自己回帰(AR)ヘッドが担います。入力側では8個のコードブックごとに独立した埋め込みを持たせ、各空間位置で連結してからバックボーンの1トークンへ射影する設計が採用されました。
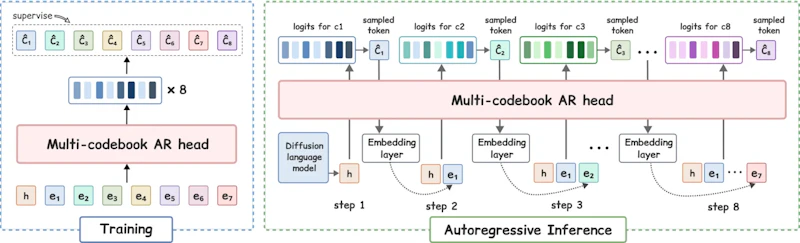
AR ヘッドは6層の因果Transformer です。図5に示すように、学習時はティーチャーフォーシングによる1回のパスで8個分のロジットをまとめて得られ、推論時はサンプリングしたコードを埋め込んで前置部分に継ぎ足しながら8ステップ進みます。位置方向は並列、コードブック方向だけ自己回帰という割り切りが、計算量を抑える要になっています。
安定化サンプリング
拡散言語モデルで画像を生成する場合、どのマスク位置をいつ確定(アンマスク)するかが速度と品質を左右します。ところが視覚位置の信頼度はテキスト用の確定しきい値より低いままで推移するため、絶対値で判断する従来のやり方が機能しません。
そこで本研究は信頼度の絶対値ではなく軌跡に注目し、値が頭打ち(プラトー)になった位置を確定対象とする Plateau-Halton sampling with V-verify(PHV)を導入しました。あわせて、隠れ状態のずれ(ドリフト)を検知したときだけキャッシュを更新する仕組みを組み合わせています。
プラトーの妥当性はオフラインでも検証されました。200件のプロンプトで、プラトー条件を満たす位置と信頼度が同程度の対照トークンをさらに2、4、8ステップ保持し続けたところ、保持を長くするほど上位1位の反転率の差が広がり、200件中157件で対照より安定していました。推論時間は1枚159.9秒・96ステップから35.9秒・約60.4ステップへ短縮され、GenEval は86.6から89.3へわずかに上がっています。Halton の開示順を外すと同等の速度で GenEval が2ポイント以上落ちるため、確定順序の設計も効いていることが分かります。
実験結果
生成系の主要ベンチマークでは、統合モデルの中で上位の成績を示しました。Ascend 910B で学習した主系列の結果を、拡散系の近縁モデル LLaDA2.0-Uni と専用生成モデル Qwen-Image と並べると次のようになります。
ベンチマーク | Intern Lumina U2 | LLaDA2.0-Uni | Qwen-Image |
|---|---|---|---|
GenEval | 89 | 89 | 87 |
DPG-Bench | 87.79 | 87.76 | 88.32 |
TIIF-Bench | 87.1 | - | 86.1 |
UniGenBench(EN) | 86.11 | 79.63 | 78.36 |
ImgEdit | 3.82 | 3.92 | - |
指示追従の総合力を測る UniGenBench では6ポイント以上の差をつけた一方、編集の ImgEdit や GEdit-Bench、世界知識を問う WISE では LLaDA2.0-Uni に届いていません。生成品質が全面的に勝っているわけではなく、得意分野の偏りが残っています。
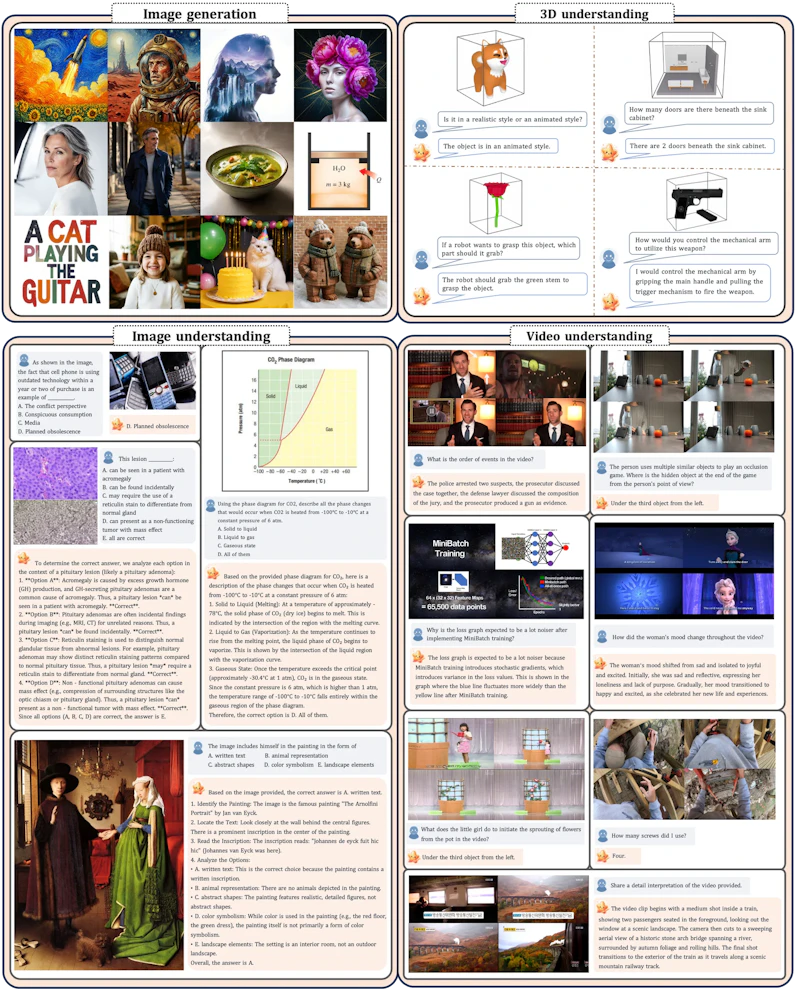
図12は生成と理解の出力例です。理解側では画像10ベンチマーク中6つで首位、8つで LLaDA2.0-Uni を上回りました。ただし RealWorldQA は62.9、MMMU は52.2 で、BAGEL や Lumina-DiMOO に劣る項目もあります。モデル内部の空間表現に踏み込んだ研究としてはS-Spaceの解析も参考になります。動画では MLVU 62.1 などで LLaDA-V を上回り、3D MM-Vet は50.5 で ShapeLLM-7B の47.4 を超えました。学習は5段階で、主系列は Ascend 910B を1024基、NVIDIA 側の参照実験は192基のGPUを使っています。
まとめと今後の展望
Intern Lumina U2 は、離散表現の扱いやすさを保ちながら容量の制約を緩める方向を示した研究です。コードブック方向だけ自己回帰にする設計と、信頼度の軌跡を手がかりにした確定判断は、拡散言語モデルで画像を扱う際の実装上の参考になります。
課題も明確です。AR ヘッドはデコードのオーバーヘッドを増やし、高解像度生成では視覚トークン列が長くなります。生成対応は画像と編集にとどまり、動画と3Dは理解のみで生成はできません。著者らは生成の動画・3Dへの拡張、より密に交互配置されたマルチモーダル生成、強化学習による事後学習、バックボーンの大規模化を今後の方向として挙げています。
論文情報: "Intern Lumina U2: A Multi-Codebook Diffusion Large Language Model for Omni-Visual Understanding and Image Generation"(Qian Yu et al., 2026) arXiv:2610.20818, CC BY 4.0
本記事の図(図3、図5、図12)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


