 AI-Papers
- マルチモーダルLLMの物体トークン表現の中に、水平・垂直・奥行きの連続座標を線形に埋め込んだ3次元部分空間「S-Space」が見つかった
- S-Spaceを書き換えると空間的な回答だけが変わり、色など非空間の回答は保持率78.13%で残る因果的な関係を確認
- 座標を外部で回転させるとSpinBenchの正答率が60.96%から94.52%へ上がり、弱点は知覚ではなく視点変換の計算にあると判明
研究の背景
マルチモーダルLLM(画像と言語を扱う大規模言語モデル、Multimodal Large Language Model)は、画像に写った物の位置関係を答える課題で不安定な振る舞いを見せます。「右か左か」といった単純な問いには答えられても、「別の人の視点から見たらどちら側か」という問いになると急に正答率が落ちます。
この失敗がどこから来るのかは、これまではっきりしていませんでした。そもそも空間を認識できていないのか、認識はできているが言語化の段階で崩れるのか、切り分ける手段がなかったためです。
清華大学などの研究チームが発表した「S-Space: Exploring Spatial Workspace in Multimodal Language Models」は、モデルの内部表現を直接調べることでこの問いに答えようとした研究です。HuggingFace Daily Papersで201票を集め、注目を集めました。
S-Spaceとは何か
研究チームが見つけたのは、中間層の隠れ状態の中にある3次元の線形部分空間です。物体名のトークン表現をこの3軸に射影すると、その物体が画面上のどこにあるか、どれくらい手前にあるかを表す連続値が取り出せます。3軸はそれぞれ水平(左右)、垂直(上下)、距離(近遠)に対応します。
図2に示すように、物体の空間座標は高次元のトークン表現の中に線形に埋め込まれており、3軸への射影によって観測者を基準とした座標が復元されます。つまりモデルは、言葉で答える前にすでに「どこに何があるか」を数値として内部に持っているということです。
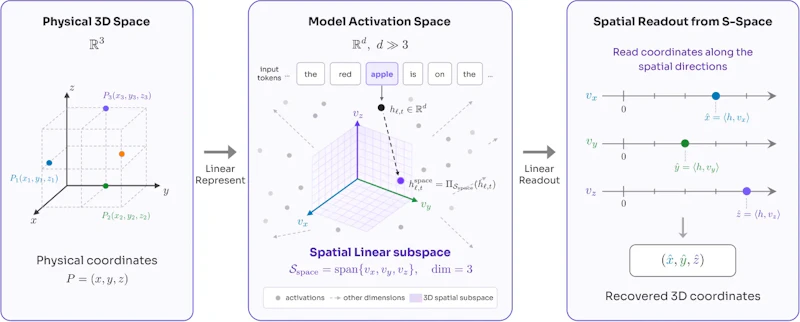
著者らはこれを内部の空間ワークスペースと位置づけています。知覚が物体の位置をここに書き込み、推論が視点変換に応じてこれを変形し、言語化の段階で必要な部分だけが読み出される、という役割分担です。
どう軸を見つけたか
軸の特定には、空間的な回答のスコアに対する勾配を使います。「right」と「left」のロジット差を物体トークンの活性化で微分し、役割の入れ替えに対して反対称になるよう整えたうえで、5種類のプロンプト、両方の物体順序、COCOデータセットの1000例について平均を取ります。この手続きで各軸ごとに1本の方向ベクトルが得られます。
対象となったモデルはMolmo2-ER、MolmoAct2-Pretrain、MolmoAct2、Qwen3.5-4B、Qwen3.6-27Bの5つです。軸が見つかった層は中間層に集中しており、たとえばMolmo2-ERでは第22層、Qwen3.6-27Bでは第43層でした。
読み出し精度の検証
取り出した座標の符号を比べるだけで、モデル自身の言語回答と同等以上の空間判断ができます。CV-Bench、EmbSpatial、SpatialTunnelの3ベンチマークでの比較は次の通りです。
モデル | CV-Bench(直接 / S-Space) | EmbSpatial(直接 / S-Space) | SpatialTunnel(直接 / S-Space) |
|---|---|---|---|
Molmo2-ER | 94.40 / 91.92 | 90.42 / 86.92 | 97.83 / 96.50 |
MolmoAct2-Pretrain | 92.32 / 91.76 | 85.33 / 90.67 | 89.50 / 91.25 |
MolmoAct2 | 91.76 / 91.44 | 88.58 / 89.92 | 89.00 / 92.75 |
Qwen3.5-4B | 73.60 / 89.36 | 78.50 / 86.42 | 86.33 / 90.08 |
Qwen3.6-27B | 93.76 / 91.84 | 91.33 / 89.00 | 96.83 / 92.92 |
Qwen3.5-4BのCV-Benchでは、直接回答の73.60%に対して内部からの読み出しが89.36%と15ポイント以上上回りました。内部には正しい情報があるのに、言語に変換する過程でそれを取り落としているという構図が見えます。
さらにS-Spaceは、空間とは無関係なプロンプトでも読み出せます。「この物体は何色か」と尋ねた場合でも同じ射影が位置判断を支え続けるため、特定のデータや指示文が作り出した一時的な表現ではなく、モデルに内在する構造だと著者らは主張しています。
介入で答えが変わるか
相関関係だけでは、S-Spaceが実際に回答を決めているとは言えません。そこで研究チームは座標を直接書き換える因果介入を行いました。Molmo2-ERの第17層で片方の物体の絶対位置をずらすと、元の回答を維持する割合は100%から41.05%まで落ちます。2つの物体の座標を入れ替えた場合も43.93%まで低下しました。
対照実験として同じ大きさのランダムな摂動を加えると、保持率は99.83%とほぼ変わりません。方向が意味を持っていることの裏付けです。同じ編集を加えたまま色を尋ねると保持率は78.13%で、空間的な回答だけを選択的に書き換えられています。
見えない対象も位置づける
S-Spaceの射影は、画面に写っていないものにも座標を与えます。画角の外にあるボールや、画像を見ている当の観測者である「you」まで、もっともらしい位置に配置されます。言語の文脈によって位置がずれることも確認されており、「あなたの方へ近づいてくるロボット」と「あなたの横を通り過ぎるロボット」で読み出される距離が変わります。
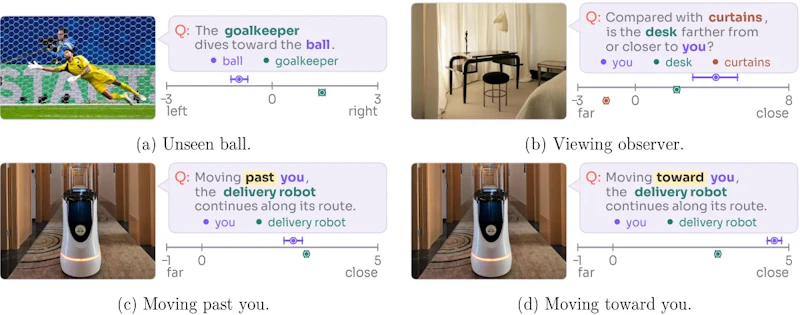
図6のように、物理的に見えていない対象にも座標が割り当てられる点は、空間表現が視覚入力だけでなく言語理解とも結びついていることを示します。その一方で、「socialist」と「conservative」が水平軸の両端に射影されるという結果も報告されており、言語上の「左右」の比喩まで同じ軸に流れ込んでいます。空間表現の汎用性と、言語学習由来のバイアスが同居している状態です。
この混在は診断ツールとしても働きます。MMSI-Benchでの方位語の分析では、Qwen3.6-27Bの推論中に現れた1311件の方位語が画像基準の軸と結びつき、「east」が右、「north」が上に対応していました。本来は絶対基準であるべき方位が画像基準と区別されておらず、地図のような軸整列した学習データの影響が疑われます。
知覚と計算の切り分け
研究の核心が、視点変換の失敗原因を分解した実験です。図8のように、S-Spaceから物体座標を読み出し、視点変換を外部で明示的に適用し、決定論的な空間規則で答えを導くという手順に分けます。これにより空間知覚と空間計算を別々に評価できます。
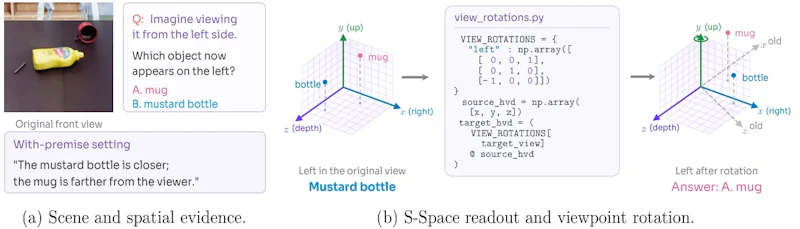
視点取得を扱うSpinBenchでの結果は次の通りです。
モデル | 直接回答 | 推論モード | S-Space + 回転 |
|---|---|---|---|
Molmo2-ER | 60.96 | 非対応 | 94.52 |
MolmoAct2-Pretrain | 66.44 | 非対応 | 96.58 |
MolmoAct2 | 71.23 | 非対応 | 95.89 |
Qwen3.5-4B | 60.96 | 62.33 | 91.10 |
Qwen3.6-27B | 60.96 | 83.56 | 95.21 |
読み出した座標を外部で回転させるだけで、Molmo2-ERは60.96%から94.52%へ跳ね上がります。正解となる視点関係を前提として与える設定では、いずれのモデルも99.31%に達しました。モデルは妥当な空間表現を作れているが、視点が変わるときに必要な変換を自力で実行できていないという切り分けです。
思考連鎖(Chain-of-Thought)の過程を追うと、推論の初期では回転後の座標による読み出しが当たり、後半では回転なしの読み出しが当たるという変化が観察されました。モデルは視点変換を部分的に内部で模擬しているものの、その変換は不完全なままです。ロボット制御に向けたLong-WAMのような長い視覚文脈を扱うモデルにとっても、空間変換をどこで担保するかは共通の課題になります。
限界と今後の展望
著者ら自身が挙げる制約もあります。水平軸と垂直軸は画像平面の座標を使っているため、奥行きに依存した遠近の効果が完全に分離できていません。基準となる視点も固定ではなく、文脈によって動き、推論の途中でも変化します。因果介入は増幅した大きさで行っており、この点は機構解析の研究で一般的な手法ではあるものの、自然な動作範囲での検証とは異なります。
比較対象としてランダム方向や主成分分析による方向との対照が報告されていないため、この3軸がどれだけ特別なのかは今後の検証課題でしょう。それでも、正確な空間表現を持ちながら言語回答に変換できないという指摘は、改善の方向をはっきりさせます。
著者らは、将来のシステムが空間変換やシミュレーション、記憶を内部計算だけに頼らず外部ツールに委ねる可能性を示唆しています。S-Spaceが測定でき編集できる対象だと分かったことで、空間知能を扱うモデルの評価と設計には新しい足場ができました。
論文情報: "S-Space: Exploring Spatial Workspace in Multimodal Language Models"(Zhiyuan Shi et al., 2026) arXiv:2610.13527
本記事の図(図2、図6、図8)は解説のため上記論文より引用しています。


