 AI-Papers
- Kaggle のコンペ情報11,649件から154件の実行可能タスクを自動構築し、エージェント学習用の環境を整備
- 連続する実験結果の間の判断をまとめて1つの実行窓とし、共有報酬を与える Windowed Interaction RL を提案
- MLE-Bench Lite のメダル獲得率がベースモデルの37.9%から72.7%へ改善し、GLM-5.3 や Kimi-K3 と同水準に到達
研究の背景
データを前処理し、モデルを選び、学習を回して精度を上げていく一連の作業は、機械学習エンジニアリング(Machine Learning Engineering、MLE)と呼ばれます。この作業を大規模言語モデル(Large Language Model、LLM)に任せる試みはすでに数多くありますが、その多くは探索の手順を人間が設計したワークフローとして外から与える方式を採っています。
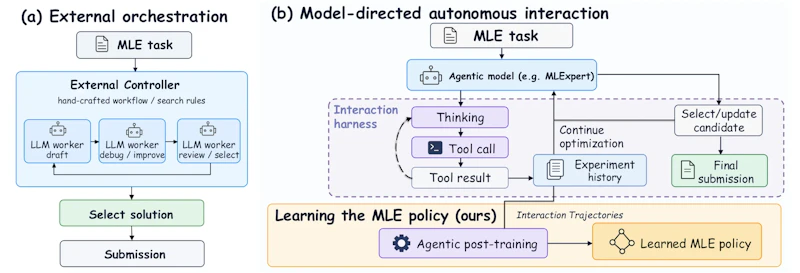
外部から制御する方式には弱点があります。どの実験を次に試すかという判断がモデルの外側にあるため、モデル自身は長期的な最適化の進め方を学習できません。足場(スキャフォールド)を外すと性能が大きく落ちる、という現象もここに原因があります。
この論文が目指すのは、モデル自身が実験状態と実行結果を見て次の行動を選ぶ、モデル主導型の意思決定です。図1はこの2つの方式の違いを対比したものです。
ただしモデル主導にすると、強化学習の設計が難しくなります。1回の学習実行には数分から数十分かかり、その間にモデルは何十回もツールを呼び出します。結果が出るまで報酬が得られないため、どの判断が良かったのかを切り分けられないのです。
タスクを自動で工場生産
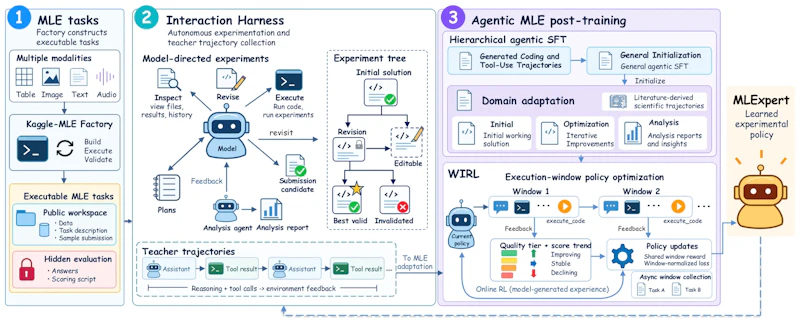
学習の前提として、評価可能なタスクが大量に必要になります。著者らは Kaggle-MLE Factory という仕組みを作り、Meta-Kaggle のコンペ情報11,649件を出発点に、発見、ダウンロード、分析、生成、実行、検証を担う複数のエージェントを連携させてタスクを組み立てました。
検証エージェントがエラーを見つけると生成側に差し戻して修復し、最後に人間がレビューします。この工程を経て160件を登録し、ラベルや採点の不備が解消できなかった6件を除いた154件が学習用タスクとして残りました。データの入手からスコア計算までが自動で回る点が、既存のベンチマーク流用との違いです。
WIRLという学習の工夫
学習は2段構えです。まず階層的エージェンティック SFT(教師ありファインチューニング)で、一般的なコーディングとツール使用の軌跡を学ばせ、続いて MLE と科学実験の教師軌跡で専門性を付けます。後段の教師データは主に GLM-5.2 が生成し、最良スコアが0.4を超えた軌跡だけを残して636件(MLE 412件、科学系224件)に絞り込みました。最良提出の後に0.05を超える性能劣化が起きた軌跡は、そこで打ち切っています。
その上に乗るのが Windowed Interaction RL(WIRL) です。連続する実験結果の間に挟まる複数ターンの判断を1つの「実行窓」としてまとめ、窓全体に結果ベースの共有報酬を与えます。報酬はモデル起因の実行エラーで -1.0、金メダル相当で 2.0 に加えて改善傾向を表す ±0.2 の項が乗ります。
さらに軌跡が終わる前にポリシーを更新できる非同期収集と、トークン単位の補正(範囲 [0.2, 4.0])を組み合わせました。これは待ち時間対策として効いており、学習側の平均待機率は GRPO の87.6%に対して WIRL では39.3%まで下がっています。図2が全体像です。
実験結果
完成した MLExpert は、総パラメータ35B、活性パラメータ約3B の Mixture-of-Experts(MoE)モデル Qwen3.6-35B-A3B を初期値としています。MLE-Bench Lite(22タスク)での「いずれかのメダル獲得率」を比較すると、同規模モデルを大きく上回り、はるかに大きなフロンティアモデルと肩を並べる水準に達しました。
モデル | メダル獲得率 |
|---|---|
Qwen3.6-35B-A3B(ベース) | 37.9% |
Ornith-1.5-35B-A3B | 39.4% |
Nex-N2.5-mini | 47.0% |
DeepSeek-V4-Pro Preview | 63.6% |
MiniMax M3 | 68.2% |
GLM-5.3 / Kimi-K3 / GPT-5.5 xhigh | 72.7% |
GPT-5.6 Sol | 77.3% |
MLExpert | 72.7% |
金メダル率も22.7%から50.0%へ伸び、銅以上の割合は62.1%から84.8%になりました。足場を変えても効果は残り、Claude Code 上で動かした場合でもベースモデルの42.4%に対して69.7%を記録しています。外部ワークフローに依存せず、モデル側に最適化能力が入ったことを示す結果といえます。
学習段階ごとの寄与を見ると、一般 SFT で47.0%、MLE SFT で62.1%、WIRL を加えて72.7%と段階的に積み上がっています。強化学習手法の比較では GRPO が56.1%、PPO 系が60.6%にとどまり、傾向報酬を外した WIRL が66.7%、ポリシー補正を外すと65.2%でした。窓単位の報酬設計と非同期化の両方が効いていることが読み取れます。
汎化と残された課題
著者らは最適化能力が MLE 以外にも波及するかを調べています。AIME 向けのエージェント足場の自動改良では、ホールドアウト精度がベースの23.3%から43.7%へ上がりました(GLM-5.3 は48.1%)。アルゴリズム最適化を問う MLS-Bench-Lite(12タスク)でも平均報酬が0.322から0.425へ改善し、12タスク中10勝1分1敗という結果でした。エージェントがエージェントを作れるかという問いは、AgentSWEのベンチマークとも重なるテーマです。
一方で限界もあります。科学研究タスクを扱う NatureBench Lite(10タスク)では、既存最高性能に並んだ割合が70%、上回った割合が50%で、GLM-5.3 や Kimi-K3 の90%、Nex-N2.5-mini の80%には届きませんでした。この評価は1回の試行に基づくもので、一部のベースライン値も著者ら自身の実行ではなく外部報告の引用です。MLS-Bench-Lite でもベースモデルに負けたタスクがあり、Gaussian splatting のタスクではスコアが0でした。
まとめと今後の展望
MLExpert の貢献は、報酬が遅れて届く長期タスクに対して、実行結果の区切りを単位に報酬を配るという素直な切り口を示したことにあります。タスク生成の自動化までを含めて一本のパイプラインにまとめた点も、追試のしやすさにつながります。
コードは GitHub、重みは Hugging Face で公開されています。35B という比較的小さな規模でフロンティアモデル級のスコアを出した事実は、AI が AI 自身の開発を担う方向の研究において、計算資源の面で現実的な選択肢が増えたことを意味します。評価の試行回数や科学研究タスクでの弱さをどう埋めるかが、次の論点になるでしょう。
論文情報: "MLExpert: Towards a Generalist Agentic Model for Autonomous Machine Learning Engineering"(Shangheng Du et al., 2026) arXiv:2610.22344
本記事の図(図1〜図2)は解説のため上記論文より引用しています。


