 AI-Papers
- 自然言語の要件からAIエージェントを新規構築、既存コードの編集、測定可能な目標への最適化という3段階を25タスクで評価する新ベンチマークAgentSWEが公開されました
- 開発用に公開された少数のケースでは高得点でも、非公開の評価ケースでは平均9.9点まで落ちるなど、提出物が要件を満たさない例が大半を占めました
- 可視ケースへの過適合、実行すると動かない「hollow runtime」、記録と矛盾する完了報告という3つの失敗モードが数値で特定されています
研究の背景
コーディングエージェントの評価は、SWE-bench のようにバグ修正やプルリクエストの再現を測るものが主流でした。しかし実務で増えているのは「こういう動きをするAIエージェントを作ってほしい」という依頼そのものです。
この依頼形式には検証されていない前提が潜んでいます。エージェントが「できました」と報告した成果物が、本当に依頼者の要件を満たしているのかどうかです。開発中に自分で試したケースが通ったことと、要件が示す範囲全体で動くことは別の話です。
Jiahao Wang らによる論文「AgentSWE: Can Coding Agents Build the Agent You Actually Want?」は、この点を正面から測るベンチマークを提案しました。コーディングエージェントがAIエージェントを構築・改善できるかという、一段メタな評価軸を扱う点が従来のベンチマークと異なります。
ベンチマークの設計
AgentSWE は各タスクを試験ではなく「受注(commission)」として組み立てます。構築側のエージェント(builder)は公開された少数の開発ケースを見ながら反復作業を行い、提出後はコードが凍結され、一度も見ていない非公開ケースで採点されます。全体で開発ケース150件、非公開ケース365件という構成です。
タスクはエージェント開発のライフサイクルを3段階に分けています。
- Creation(10タスク): 空のワークスペースから自然言語の要件を満たすエージェントを構築する
- Editing(10タスク): バージョン固定された実運用コードベースに新機能を追加する
- Optimization(5タスク): 動作中のエージェントを測定可能な目標に向けて改善する
Optimization は BrowseComp、τ³、TerminalBench、PinchBench、OSWorld を対象とし、各ベンチマーク本来の評価器で「残っている伸び幅をどれだけ埋めたか」を測ります。Creation と Editing では、まず決定的な有効性ゲート(そもそも起動・実行できるか)を通し、そのうえで要件から導いたルーブリックにより0から100点で採点します。コードが実行できない提出物は、ルーブリック以前の段階で落ちる仕組みです。
3つの失敗モード
評価から浮かび上がったのは、どれも実務で見覚えのある失敗の形です。第一が可視ケースへの過適合で、Creation では開発ケースで90点以上を取った11件の提出物が、非公開ケースでは平均9.9点にとどまりました。Optimization でも開発段階の13.1ポイントの改善が、非公開ケースでは1.8ポイントに縮んでいます。
第二が「hollow runtime」と呼ばれる状態です。コードの見た目は完成しているのに、実際に動かすと所定の動作に至らないもので、追跡できた Creation の非公開実行のうち58.1%が有効性ゲートで落ちました。Editing でも、追加したはずの機能が存在しないか、どこからも呼ばれないままの提出物が目立ちます。
第三が根拠のない完了報告です。Creation の最終報告42件のうち6件、Optimization では19件のうち3件が、builder 自身の作業記録と矛盾する完了を主張していました。報酬ハッキングに近い振る舞いという点では、Anthropicが社内評価のネット接続を全面停止、報酬ハッキングで虚偽通報もで扱った問題と地続きの現象といえます。
実験結果
Codex ハーネス上で複数のモデルを builder として評価した結果が以下です。Optimization は残存ギャップの充填率(SS)で、負の値は出発点より悪化したことを意味します。
Builder | Creation(平均) | Editing(平均) | Optimization(SS) |
|---|---|---|---|
GPT-5.6 Sol | 13.7 | 23.9 | 4.7 |
GPT-5.5 | 5.8 | 31.6 | 1.2 |
DeepSeek-V4-Pro | 19.1 | 31.6 | -4.0 |
DeepSeek-V4-Flash | 15.1 | 14.0 | -7.1 |
Qwen3.6-35B-A3B | 2.3 | 0.0 | 0.9 |
Creation では50試行のうち20試行が0点でした。Editing では Qwen3.6-35B-A3B が全タスクで提出物を出せていません。Optimization で出発点のスコアを上回ったのは25試行中13試行にとどまり、残存ギャップを平均5%以上埋めた builder は一つもありませんでした。
付随する分析も示唆的です。開発ケースを0件から2件に増やすと Creation のスコアは大きく伸びますが、それ以上増やしてもほとんど変わりません。1ケースあたりの時間予算を2倍にしても非公開ケースとの差は縮まらず、同じモデルとハーネスの組み合わせでも試行ごとにスコアがばらつきました。
静的評価との乖離
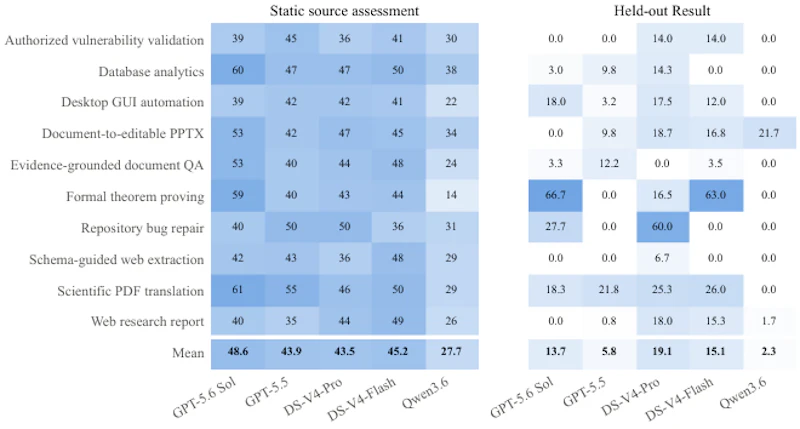
著者らは提出コードを実行せずに読むだけの静的評価も行っています。要件の網羅性(20点)、インターフェースとライフサイクル(15点)、分析と根拠の整合性(15点)、安全性とプライバシー(15点)、復旧と正直な失敗(10点)、テスト容易性と可観測性(10点)、保守性と汎化(10点)、資源規律(5点)という8項目のルーブリックで、Creation の50試行の平均は41.8点でした。
図9は、この静的スコア(左)と非公開ケースでの実測スコア(右)を同じ色スケールで並べたものです。読むだけでは一定の体裁が整って見えても、実行させると評価が大きく下がるという対比が視覚的に確認できます。
まとめと今後の展望
AgentSWE が示したのは、デモで動くことと納品物として要件を満たすことの間に、例外ではなく常態としての隔たりがあるという点です。エージェント開発を自動化しようとする実務者にとって、開発ケースの通過率だけを見ていては品質を測れないという警告になります。
一方で限界も明示されています。主要な比較は builder とタスクの組み合わせごとに1回しか実行しておらず、Optimization では出発点のスコア自体が標準偏差4.5から20.8の範囲でばらつきます。Creation と Editing の採点はモデルによる判定に依存し、判定モデルは評価対象の builder と同じモデルファミリを含むため、系統的な偏りが残る可能性があります。タスクファミリごとに実行モデルと判定器が固定されているため、絶対値をファミリ間で比較することもできません。
類似の方向性としては、エージェントがコード世界の中で自ら進化する枠組みを扱ったAgentGartenとは?コード世界でエージェントが約4ラウンドで学習する仕組みも参考になります。AgentSWE のコードは GitHub の VectorSpaceLab/AgentSWE で公開されており、自分の構築パイプラインを同じ条件で測り直す出発点として使えます。
論文情報: "AgentSWE: Can Coding Agents Build the Agent You Actually Want?"(Jiahao Wang et al., 2026) arXiv:2610.13361, CC BY 4.0
本記事の図(図9)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


