 AI-Papers
- Metaが総パラメータ約816B、トークンあたり活性約42BのMoEモデル Muse Spark Open をオープンウェイトで公開した
- テキスト・画像・音声・動画を入力でき、文脈長は最大1,048,576トークン。出力はテキストのみ
- BF16とNVFP4の公式チェックポイントに加え、GGUF・MLX量子化やvLLM、SGLang、llama.cppでの実行手順が公開初日から揃う
816BのMoEをオープン公開
Metaがオープンウェイトのマルチモーダルモデル Muse Spark Open を2026年10月15日に公開し、Hugging Face の公式ブログで構成と動かし方が解説されました。チェックポイントは BF16 の Muse-Spark-Open-816B-A42B と、NVIDIA Blackwell 世代向けの4bit版 Muse-Spark-Open-816B-A42B-NVFP4 の2種類です。
同ブログはこのモデルを「現時点で最も能力の高い米国製オープンウェイトモデル」と位置づけています。8月に公開された小型の密結合モデル Muse Glimmer と同じ系列で、トークナイザと語彙を共有し、チャットテンプレートも Glimmer のものに新しいモダリティ向けの記述を追加した形です。密結合のフィードフォワード層を Mixture-of-Experts(MoE、複数の専門家ネットワークを切り替える構成)ブロックに置き換えた点が最大の違いになります。クローズドモデルであるMuse Wonderとは別系統の公開モデルです。
アーキテクチャの構成
本体は62層、隠れ次元8192の構成です。各 MoE 層には256個のエキスパートが置かれ、トークンごとに8個だけが選ばれます。エキスパートの FFN は 8192 から 4096 を経て 8192 に戻る形で、全パラメータの約97%がここに集中しています。
注意機構は Grouped-Query Attention(GQA)で、クエリヘッド128に対して KV ヘッドは16、1ヘッドあたり64次元です。QK 正規化と出力ゲートが加えられ、埋め込み行列と出力行列はそれぞれ約1.66Bパラメータで分離されています。
知覚側は独立したエンコーダが担当します。画像と動画は1.8Bパラメータ、50層、隠れ次元1536の Perception Encoder が14×14のパッチを4096次元の特徴に変換します。音声はモノラル24kHzを入力とし、80ミリ秒ごとに1トークン(毎秒12.5トークン)へ圧縮します。動画は既定で毎秒2フレーム、最大96フレームまでを取り込み、processor.video_processor.fps で変更できます。
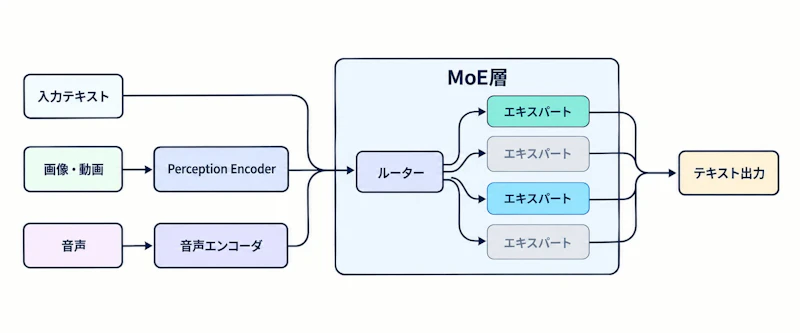
図1のように、各モダリティはエンコーダを経て同一のトークン列に合流し、MoE 層のルーターが選んだ少数のエキスパートだけを通過してテキストとして出力されます。
1Mトークン文脈の代償
文脈長の上限は1,048,576トークンですが、その分 KV キャッシュの負担が重くなります。1トークンあたり 2×16ヘッド×64次元×62層で126,976個の値が加わり、BF16 ではおよそ250KBです。上限いっぱいまで埋めると約266GBに達するため、長文脈運用では重みとは別にこの領域を確保する必要があります。
重み自体も軽くはありません。BF16 の safetensors は約1.5TB で、トークンごとに動くのは42B相当でも、256個のエキスパートはすべてメモリ上に載せておく必要があります。
動かすための実行環境
ブログでは Transformers、llama.cpp、vLLM、SGLang、MLX、Hugging Face Inference Endpoints の手順が示されています。検証された構成と実測値は次の通りです。
実行環境 | 構成 | メモリ・速度 |
|---|---|---|
Transformers(BF16) | H200×8のノード4台(TP=32) | 重み約1.5TB |
Transformers(NVFP4) | B200ノード1台 | 4bit量子化 |
vLLM | Blackwell GPU、TP=4 | 128Kまでの提供文脈 |
SGLang | GB300×4(TP=4、EP=4) | NVFP4チェックポイント |
llama.cpp(GGUF Q2_K) | Mac M3 Ultra 512GB | 304GB、約18トークン/秒 |
MLX(oQ3e) | Mac M3 Ultra 512GB | 約344GB、生成21トークン/秒 |
GGUF は Q2_K、Q4_K_S、Q8 が llama.cpp で検証され、MLX 版は mlx-community から oQ3e と oQ4e が提供されています。Inference Endpoints では RTX Pro 6000(98GB)8枚で131,072トークン、H200(141GB)8枚で1,048,576トークンの文脈が選べます。
推論努力度とツール呼び出し
チャットテンプレートは gpt-oss で導入されたチャネル方式(Harmony)を踏襲し、推論、コメンタリー、最終回答のチャネルを分けます。推論の深さは low、medium、high、xhigh の4段階で、それぞれ内部値16、64、256、512に対応し、システムプロンプトで数値を直接指定することも可能です。既定値は xhigh です。
推論そのものを無効化する手段はないため、単純なタスクでも効力を low に下げない限りトークンを消費します。ツール呼び出しはテキストのみの場合とマルチモーダル入力を伴う場合の双方に対応しています。
LoRAによる微調整の実例
TRL の SFTTrainer を使った微調整例も示されました。H100を8枚積んだノード8台、計64GPUで fsdp_size=64、ep_size=8 を指定し、q/k/v/o の射影に LoRA(r=16、alpha=32)を当ててエキスパートは凍結する構成です。
データセットは allenai/tulu-3-sft-mixture、系列長2048でパッキングを有効化し、500ステップを約2時間、毎秒約8,000トークンで処理しています。トークン精度は72%から84%へ上がり、損失は1.26から0.57に下がりました。フル微調整ではなく、凍結を前提にした現実的な手順が示された形です。
導入前に見ておく制約
公開初日から多くの実行経路が揃う一方、ブログ自身が挙げている注意点もあります。
- vLLM の参照実装はテキストと画像のみで、Blackwell GPU が前提
- 量子化モデルはプロンプトでの誘導をより丁寧に行う必要がある
- 推論を完全に切ることはできず、トークン消費が常に発生する
- 掲載コードに
reasoning_strengthとreasoning_effortの表記揺れなど誤りが残る
ライセンスや利用条件については記事中に明示がありません。自社 GPU やローカル環境でフロンティア級のマルチモーダルモデルを検証できる選択肢が増えた一方、必要なメモリ規模を考えると、まず NVFP4 や GGUF の量子化版から試す流れが現実的でしょう。


