 AI-Papers
- 点とボックスを共有語彙の量子化座標として統一出力する4Bモデルで、34ベンチマーク平均73.68%を記録し、GPT-6 Astraの71.54%を上回りました
- マルチモーダル事前学習、座標アラインメント(SFT)、GRPOによる強化学習の3段構成で空間認識を鍛えています
- 視覚バックボーンとしてロボット操作と自動運転の性能を改善しつつ、GUI操作画面のグラウンディングなど苦手分野も論文内で明示されています
研究の背景
ロボットや自動運転のように物理世界で動くAIにとって、「どの物体が対象で、それがどこにあるか」を正確に言い当てる能力は出発点になります。この能力はビジュアルグラウンディング(画像内の指示対象を位置として特定する処理)と呼ばれ、画像とテキストを扱うマルチモーダルモデルの基本機能として扱われてきました。
ところが論文の著者らは、現在のVision-Language-Action(VLA)モデルや世界モデルが汎用バックボーンに依存しており、散らかった場面、ごく小さな物体、閉ループ制御といった条件では位置特定が崩れると指摘します。汎用モデルは会話や推論には強くても、ミリ単位の位置を返す訓練を十分に受けていないという見立てです。
そこで提案されたのが GroundingPI です。arXiv に2026年9月30日に投稿された64ページの論文で、26名の著者が名を連ねています。狙いは、グラウンディングを後付けの機能ではなく基盤モデルの生得的な能力として作り込み、その視覚表現を物理知能(physical intelligence)側に流し込むことにあります。
提案手法
GroundingPI は言語側のバックボーンに Qwen3-4B を使い、マルチモーダル全体で約48.4億パラメータという構成です。鍵になるのは出力形式の統一で、語彙に1000個の座標トークンとカテゴリ区切り記号を追加し、点(pointing)もボックス(bounding box)も同じ語彙上の量子化座標として生成します。座標トークンの学習には IoU のような専用の回帰損失を使わず、通常のトークンと同じクロスエントロピー損失をそのまま適用します。
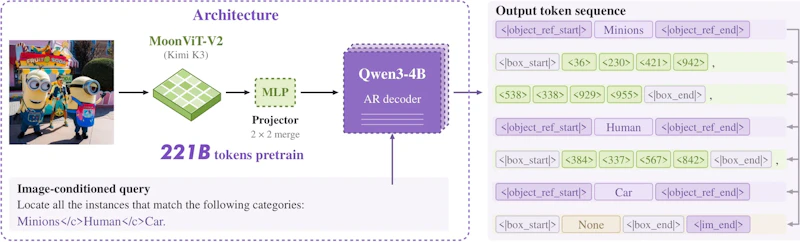
図1に示すように、モデルは複数カテゴリの問い合わせを受け、存在するカテゴリには座標を、存在しないカテゴリには None を返します。該当なしを明示的に出力させる設計は、存在しない物体を無理に探し当てる誤検出を抑える役割を担います。
学習は3つの段階を順に進めます。前半はプロジェクタの整列から全モジュールの同時学習までを含むベース VLM の事前学習、続く第4段階が空間タスクに特化させる座標アラインメント(SFT)、最後が GRPO(Group Relative Policy Optimization、グループ内の相対評価で方針を更新する強化学習手法)です。
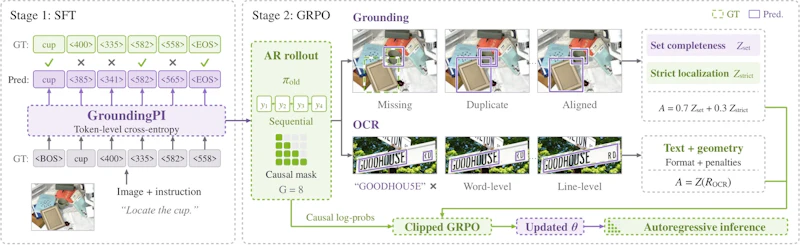
図3の後半に当たる GRPO では、報酬の設計が具体的です。グラウンディングでは集合としての網羅性に0.7、厳しめの位置一致と出力品質に0.3という重み付けを与え、OCR(画像内文字認識)にはテキストと形状の整合性を見る複合報酬を用います。KL ペナルティの基準は SFT 済みチェックポイントです。網羅性を重く置くことで、取りこぼしを減らしながら位置を詰める方向に学習が進みます。
学習データは公開データセットと独自のデータエンジンの併用です。複数の教師モデルが出した候補ラベルをフィールド単位で統合し、問い合わせが要求する項目すべてが検証を通過した場合のみ学習データとして採用します。検証済みラベルはグラウンディング、参照表現、ポインティング、OCR と横断的に再利用されます。著者らは、教師モデル同士の一致は検証の助けにはなるが正解を保証するものではない、と注意書きを添えています。
実験結果
評価は11種類の知覚能力をカバーする34ベンチマーク、44のベースラインという規模で行われました。平均スコアは73.68%で、比較対象の GPT-6 Astra の71.54%を上回っています。4B 規模のモデルがフロンティア級のモデルを平均値で超えた点が、この論文の中心的な主張です。
物理知能への転移も検証されています。行動を出力するアクションエキスパートや学習予算を固定したうえで視覚バックボーンだけを差し替える比較設計で、主要な結果は次の通りです。
評価 | GroundingPI | 比較対象 |
|---|---|---|
34ベンチマーク平均 | 73.68% | GPT-6 Astra 71.54% |
RoboTwin 2.0(分布外4設定) | 最大24.8%の相対改善 | 最良の既存バックボーン |
RoboCasa-GR1(全データ) | 37.75% | RynnBrain 39.00% |
nuScenes 開ループL2誤差 | 平均0.296 m | (低いほど良い) |
ScreenSpot-Pro | 65.78 | GPT-6 Astra 93.17 |
RoboCasa-GR1 では、デモンストレーションの50%だけで学習した GroundingPI が、75%で学習したベースラインを上回りました。少ないデモで同等以上に達するという結果は、知覚の質がデータ効率に効くという解釈を支えます。一方で全データを使った条件では RynnBrain の39.00%に対して37.75%と逆転されており、常に優位というわけではありません。
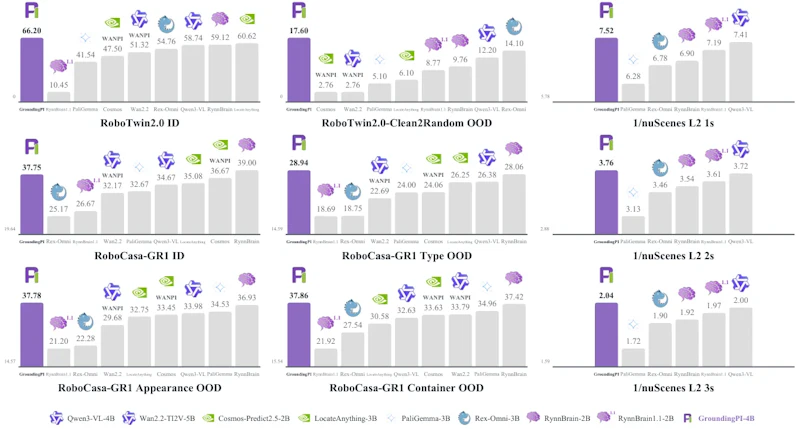
図5は操作成功率と運転性能をまとめたものです。自動運転は開ループ評価、つまり自車の予測軌跡を正解軌跡と比べる方式であり、実際に制御が閉ループで成立するかは示していません。デプロイ時の遅延も未評価だと論文は明記しています。
データ構成の寄与を調べる leave-one-out の除去実験も行われています。知覚タスク群のうち、密集した物体と微小物体のグラウンディング群を外したときに下流性能の落ち込みが最も大きく、この能力が操作と運転の両方を支えていることが示されました。OCR データを除いた際も操作性能が大きく下がりましたが、著者らはこれを「OCR が知覚学習の触媒になっている」という仮説の段階として扱い、因果関係を主張していません。
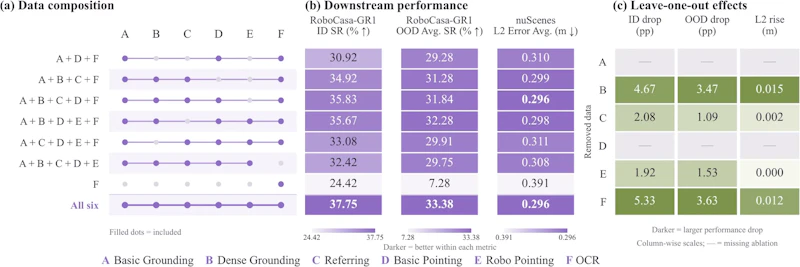
図9の差分を見ると、知覚監督の種類ごとに転移の効き方が異なります。論文の考察では、ボックスや点によるグラウンディングが、画像からはスケールが曖昧になりがちな絶対距離の深度損失よりも明示的な空間理解を強く要求するのではないか、という見方も提示されています。マルチモーダルモデル内部の空間表現についてはS-Spaceとは?マルチモーダルLLM内部の空間ワークスペースを因果介入で検証も合わせて読むと理解が進みます。
まとめと今後の展望
GroundingPI の貢献は、点とボックスを同一語彙の座標トークンに統一し、SFT と GRPO で位置精度と網羅性を同時に鍛えた点、そしてその視覚表現がロボット操作と自動運転に転移することを固定条件下で示した点にあります。著者らは System 2 の計画には Astra のような汎用フロンティアモデルを、System 1 の実行には速く正確な知覚を担う専用基盤を、という役割分担を構想として述べています。
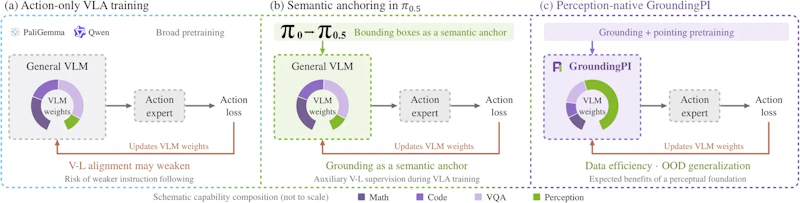
図6はその構想を概念図として整理したものです。もっとも、論文自身が限界を率直に並べています。全面的な優位は示されておらず、Dense200 のポインティングや空間・GUI 系の一部では Astra が依然として上、ScreenSpot-Pro では65.78 対93.17 と大きく離されています。微小ボックスの位置特定、高 IoU が要求される境界精度、TotalText も弱点として挙げられました。
ベース言語モデルの違いが下流性能を左右する可能性や、OCR データの役割といった考察も、著者ら自身が未検証の仮説と位置づけています。コード、重み、評価データの公開が予告されているため、閉ループ制御や実機での遅延を含む追試がどこまで主張を支持するかが次の焦点になります。
論文情報: "GroundingPI: A Grounding Foundation Model towards Physical Intelligence with Visual Primitives"(Qize Yu et al., 2026) arXiv:2609.39601, CC BY 4.0
本記事の図(図1、図3、図5、図6、図9)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


