 AI-Papers
- 総パラメータ35B・トークンあたり3B活性のMoEを採用した音声生成モデルで、重みとSGLang-Omni向け推論環境が公開されている
- 「囁いて」などの自然言語の演技指示に追従し、Expressoの評価では指示ありで囁き読みが62.2%選ばれた(指示なしは10.6%)
- 人間の嗜好を学習した報酬モデルのみを使うRLで、Seed-TTS-Evalの1テイク目の不良率が2.82%から1.24%へ低下
研究の背景
音声合成(Text-to-Speech、TTS)は、ここ数年で「人間らしく読める」水準に到達しました。しかし実際の制作現場で必要なのは、正確な読み上げだけではありません。この台詞をもう少し小声で、ここは笑いながら、といった演出の指示を反映させる作業が欠かせません。
従来のモデルでは、こうした演出を参照音声の選び直しや感情ラベルの切り替えで表現するのが一般的でした。ラベルの種類は固定されているため、細かなニュアンスの指定には向きません。さらに、出てきた音声が気に入らなかったときに「もう少し落ち着いて言い直して」と伝え直す仕組みも標準では用意されていません。
Fish Audioの研究チームが公開した技術報告「Fish Audio Drama 3」は、テキストを演出済みの演技(directed performance)へ変換することを目標に据えたモデルです。声のキャスティング、自然言語による演出指示、ダメ出しによるテイクの修正、複数キャラクターのシーン、既存音声の部分差し替え、長尺とストリーミング合成を1つのモデルに統合しています。
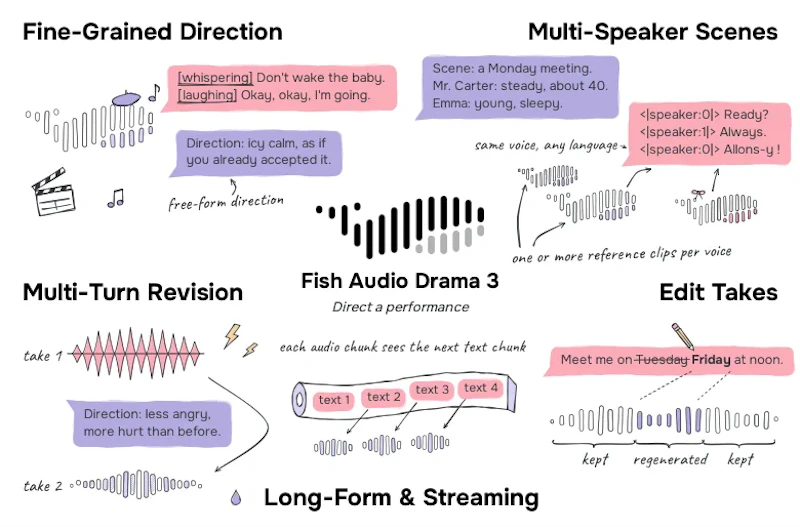
図1に示すように、これらの機能はそれぞれ別個のツールではなく、同じ対話形式のインタフェースの上で扱われます。利用者は演出家のように指示を出し、不満があれば次のターンでメモを渡す、という流れで使う設計です。
提案手法
バックボーンは Qwen3.5-35B-A3B の言語モデル部分から初期化された40層構成で、総パラメータは35B、トークンあたりの活性は約3Bです。各層のフィードフォワード部は Mixture-of-Experts(専門家を切り替える仕組み)で、256個のルーティング専門家から8個と共有専門家を使います。注意機構は Gated DeltaNet を3層並べて1層のゲート付きフルアテンションを挟むハイブリッド構成で、長い系列を扱いながら計算量を抑えています。
音声の表現には前世代の Fish Audio S2 のトークナイザを再利用しています。44.1kHzの音声を毎秒約21.5フレームに圧縮し、1フレームを10個のコードブック(符号表)で表します。コード0は意味的な情報を担い、コード1から9が音響的な細部を担当します。
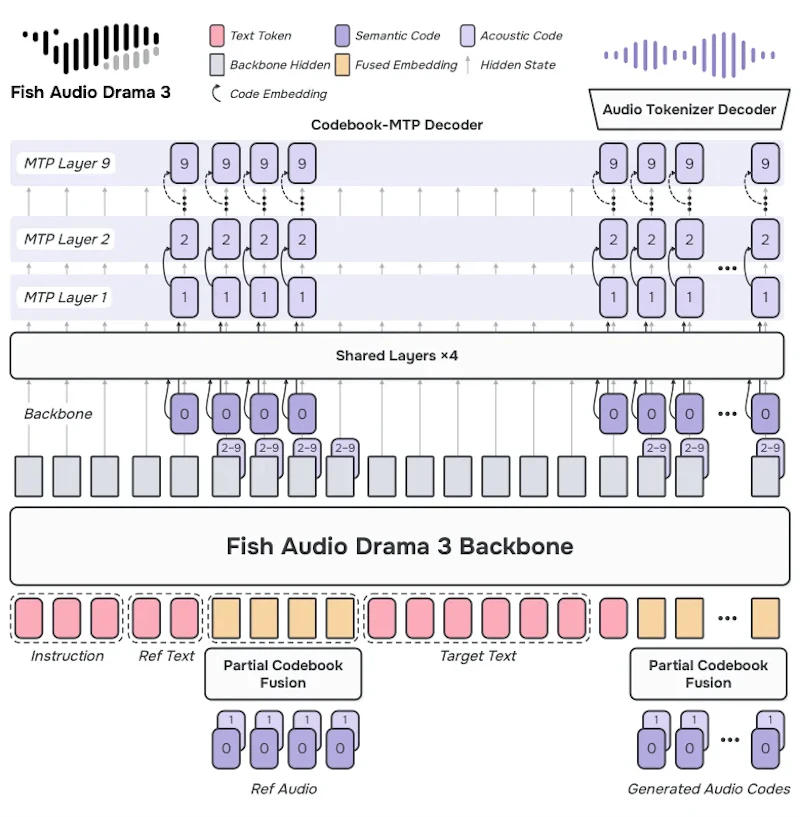
図2が示す通り、バックボーンに戻されるのはコード0と1を融合した埋め込みだけで、コード2から9はバックボーンを迂回してデコーダ側に直接入ります。この部分的なコードブック融合により、重いバックボーンが処理する情報量を抑えつつ、音響の細部はデコーダに任せられます。
デコーダは4層の共有層と9層のコードブック別層から成る13層構成で、各層が1つの音響コードを担当します。S2のフレーム単位の高速自己回帰と違い、各層が系列全体に対して時間方向に因果的な注意を向ける点が変更点です。
学習は3段階の事前学習、指示追従のための指示チューニング、そして強化学習(RL)の順に進みます。事前学習は約80の言語・方言にまたがる数千億トークン規模で、系列長を8Kから16Kへ伸ばしながら Muon で最適化します。指示チューニングでは最大32Kの系列で演出指示、複数話者の対話、シーンの吹き替え、複数ターンの修正を学ばせています。
RLには GRPO を使い、1つのプロンプトから8テイクを生成します。KL罰則もルールベースの報酬も使わず、報酬は人間の嗜好を学習した報酬モデル1つだけです。1ステップあたり1,536プロンプトという大きなバッチで回し、デコーダは凍結したままバックボーンのみを更新します。
実験結果
演出指示への追従は Expresso を使って評価されています。報酬モデルによる比較で、指示を与えた場合に囁いた読みが選ばれた割合は62.2%、笑いながらの読みは64.4%でした。指示がない場合はそれぞれ10.6%、27.1%にとどまります。一方で話者の類似度では、通常の読みのほうが99.7%、93.9%と高く選ばれており、演出を付けると声の同一性は犠牲になる傾向が見て取れます。
RLの効果は読み上げ精度に明確に現れました。主要な数値を整理します。
指標 | RL前 | RL後 |
|---|---|---|
Seed-TTS-Eval 不良テイク率(中国語) | 2.82% | 1.24% |
Seed-TTS-Eval 不良テイク率(英語) | 3.40% | 1.84% |
1テイク目の CER(中国語) | 1.66 | 1.00 |
1テイク目の WER(英語) | 3.49 | 2.20 |
ここでの不良テイク率は、信号チェックを通らなかった1テイク目の割合を指します。言い直しが必要になる頻度が半分以下に減ったことになり、実用上は生成のやり直しコストに直結します。
推論速度は単一ストリームでH200 1枚あたり271フレーム/秒で、S2の177フレーム/秒を上回りました。パラメータ数が7倍以上であるにもかかわらず速くなっている点が特徴です(AI向けGPU比較2026、H200とB200とRTX 5090をLLM推論性能とVRAMで選ぶも参考になります)。B300では295フレーム/秒、さらにプリフィルとデコードを分離することで、同じサービス水準で1GPUあたり約10ストリームから24ストリームへ収容数が増えています。
ストリーミング合成ではWERが1.86、非ストリーミングが1.83で、話者類似度はどちらも0.640でした。逐次生成に切り替えても品質の劣化はほぼありません。参照音声を1本から3本に増やすと、LibriSpeech-PC の話者類似度は0.605から0.633へ改善しています。
音声編集では中国語の Ming-Freeform で挿入0.909、置換0.898と最高の類似度を記録し、基本分割でのWERは3.69で、比較対象の Cartesia Sonic-3(8.64)を下回りました。複数ターンの修正については Step-Audio-Edit で3ラウンドを通して感情の正答率が55.5から58.2、スタイルが76.5から81.8へ上がっています。
まとめと今後の展望
Drama 3 は、音声生成を「読み上げ」から「演出された演技」へ寄せる設計を、オープンウェイトで示した事例です。部分的なコードブック融合とコードブック単位のMTPデコーダにより、大きなMoEバックボーンを使いながら前世代より高いスループットを達成した点は、実装上の参考になります。
ただし万能ではありません。複数ターンの修正では感情の正答率が Step-Audio-EditX(3回目で69.3)に届かず、笑い声などのパラ言語的イベントの評点も2.32対2.89で劣ります。広東語のCERは22.70で OmniVoice の17.71より高く、ギリシャ語やルーマニア語、インドネシア語、ウクライナ語などでも最良ではありません。報告されているベースラインの一部は採点手順が異なる論文からの引用で、著者自身も直接比較には限界があると注記しています。
重みは GitHub(fishaudio/fish-speech)と Hugging Face(fishaudio/drama-3)で公開され、推論は SGLang-Omni から利用できます。声の複製や演技の再現が容易になるほど、本人同意や成果物の扱いをどう線引きするかという運用面の設計も同時に必要になるでしょう。
論文情報: "Fish Audio Drama 3 Technical Report"(Dawei Han et al., 2026) arXiv:2610.18010, CC BY 4.0
本記事の図(図1〜図2)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


