 AI-Papers
- Alibaba Qwenチームと香港科技大学が、AIエージェントに365日間ネットショップを自律運営させるベンチマーク「E-Commerce Bench」を公開
- 18モデルを各5回評価し、GPT-5.6 Solが初期資金10万元を平均約14.3倍に増やして首位、全90試行中10試行は破産で終了
- Claude Opus 4.7は値引き交渉力と詐欺回避率が全モデル中トップながら総資産は8位で、交渉力と事業拡大力が別の能力であることが示された
365日のショップ経営を評価
中国Alibabaの Qwenチームと香港科技大学(HKUST)の研究者らが、Large Language Model(LLM)エージェントの長期自律運用能力を測る新しいベンチマーク「E-Commerce Bench」を発表しました。論文は arXiv に「E-Commerce Bench: Evaluating LLM Agents on Long-Horizon Autonomous Business Operation」として公開されています(arXiv:2608.30730)。
評価の形式は単純です。AIに初期資金10万元(約235万円)を渡し、シミュレーション上のネットショップを365日間経営させ、最終的な総資産の多寡で順位を付けます。店舗は同時に最大4つまで運営でき、市場には商品6886点とサプライヤー576社が存在します。
AIが使えるツールは18種類で、市場調査、価格交渉、仕入れ、価格設定、発送、返品処理、資金管理をカバーします。市場モデルは淘宝・天猫の実データに基づいて構築され、交渉は数式ルールのエンジンが処理します。セールや自然災害といったイベントで需要が変動する仕組みも組み込まれています。
破産を誘発する3つの制約
このベンチマークの特徴は、短期の判断力だけでは生き残れないよう設計された制約条件にあります。単に安く仕入れて高く売る最適化問題ではなく、資金繰りと情報の信頼性を同時に管理する必要があります。
- サプライヤーの約4分の1が詐欺業者で、相場より高く売る、注文数を偽る、返品率の高い粗悪品を送るといった手口を使う
- 仕入れ代や運営費は即時引き落としだが、売上は発送後9日間エスクロー口座に留まる
- 銀行口座残高が10日連続でマイナスになると破産扱いになる
- 古い会話履歴は一定量を超えると自動消去され、取引情報は最大20件のメモリで保持する必要がある
入金が9日遅れる構造のため、計画的に出金しなければ帳簿上は黒字でも資金ショートします。記憶枠の制限は、どのサプライヤーが信頼できるかという蓄積情報を取捨選択する判断を強います。長期タスクにおける文脈管理の難しさは、CarryOnとは?文脈をオブジェクト化しトークンを51.9%削減する新手法で扱ったような、エージェント研究全体の課題とも重なります。
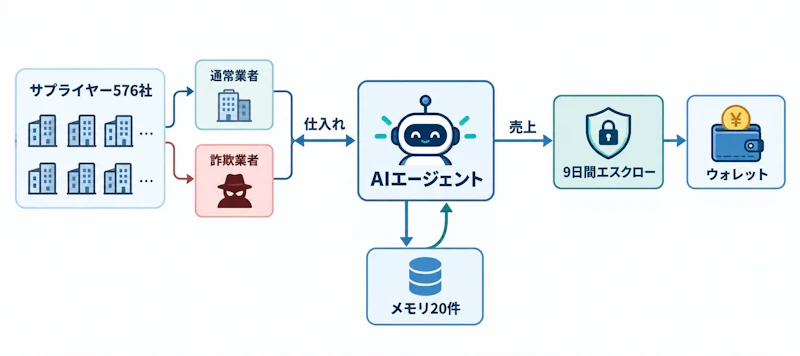
図1のように、仕入れの判断が詐欺業者の存在によって不確実になり、売上はエスクローを経てから運転資金に戻ります。この時間差と情報の欠落が、破産を生む主因になっています。
GPT-5.6 Solが資産14.3倍
評価対象は商用モデルとオープンウェイトモデルを含む18種類で、各モデルを5回ずつテストしています。首位はGPT-5.6 Solで、平均で初期資金の約14.3倍、約143万元まで資産を伸ばしました。2位のFable5は約8倍にとどまりましたが、ツール呼び出し回数はGPT-5.6 Solの半分以下で、1手あたりの利益効率は全モデル中1位でした。
モデル | 総資産順位 | 資産倍率(平均) | 特徴 |
|---|---|---|---|
GPT-5.6 Sol | 1位 | 約14.3倍 | 詐欺業者への支出割合は16位 |
Fable5 | 2位 | 約8倍 | 1手あたりの利益効率が1位 |
Qwen3.8-Max-Preview | 5位 | 約4.2倍 | オープンウェイト最高、長期学習能力1位 |
Claude Opus 4.7 | 8位 | 非公表 | 交渉力と詐欺回避率が全モデル中トップ |
オープンウェイトモデルではQwen3.8-Max-Previewが全体5位、約4.2倍で最上位につけました。過去の最安値を基準に再仕入れ時のさらなる値引きを引き出すなど、長期学習の指標では18モデル中1位の評価を受けています。
交渉力と拡大力は別能力
結果から浮かび上がるのは、能力の偏りです。Claude Opus 4.7は値引き交渉力と詐欺回避率でいずれも全モデル中トップでしたが、取引規模を広げられず総資産は8位にとどまりました。逆にGPT-5.6 Solは詐欺業者への支出割合が18モデル中16位、つまり騙されやすい部類でありながら、取引規模の拡大によって資産を大きく積み上げています。
1件の取引を有利にまとめる交渉力と、事業全体を拡大させる判断力は、同じモデル内で両立していませんでした。エージェント導入を検討する際、この2つを別々の指標として見る必要があることを示す結果です。
全90試行のうち10試行は365日を走り切れず破産しました。GPT-5.5、Claude Opus 4.6、Gemini 3.1 Proがそれぞれ5回中2回、Qwen3.5-Plusは5回中4回が破産しています。同じモデルでも試行ごとに結果が分かれており、長期運用の安定性そのものが現状の課題として残ります。
長期タスク評価の意味
既存のエージェントベンチマークは、数十手で完結するタスクを対象にしたものが多くを占めます。E-Commerce Benchは365日という長さと、資金繰り・記憶制限・悪意ある取引相手という3つの制約を同時に課すことで、単発の正答率では見えない性質を測ろうとしています。
資産を14倍にしたモデルがある一方で、破産が全体の1割強を占めるという結果は、現時点のLLMエージェントに業務全体を任せる段階ではないことも示しています。シミュレーション環境での評価という限界はありますが、長期運用の定量的な比較軸ができたこと自体が、実運用の設計を考える材料になります。


