 AI-Papers
- Google DeepMindとシンガポール政府技術庁(GovTech)が、端末上で動く会話型詐欺の検知モデルを共同開発した
- 軽量分類器による一次スクリーニングと、ファインチューニング済みGemmaによる会話全体の精査という二段構成を採用
- 学習はGovTech管理のクラウド環境内で行い、個人情報を含まない匿名化データのみを使用した
国家規模の詐欺対策
Google DeepMindは2026年10月14日、シンガポール政府技術庁(GovTech)との共同で、スマートフォン端末上だけで会話型詐欺を検知するAIモデルを開発したと公表しました。両者が2026年5月に発表したNational AI Partnershipの一環で、成果はSingapore International Cyber Week(SICW 2026)で紹介されています。
シンガポールでは詐欺が報告された犯罪件数の半数以上を占め、2019年以降の被害額は40億シンガポールドルを超えました。手口は不審なリンクを踏ませる従来型のフィッシングから、対話を重ねて相手を信用させるソーシャルエンジニアリングへ移っており、こうした会話型の詐欺が被害額の最大8割を占めるとされます。
会話型の詐欺はリンクやファイルのような明確な悪性シグナルを伴いません。相手を焦らせたり権威を装ったりする文脈そのものが手がかりになるため、単語やURLのブラックリスト照合では捉えにくい領域です。
二段構成にした理由
開発されたシステムは処理を2段階に分けています。第1段階では低消費電力の軽量分類器が受信メッセージをふるい分け、問題のない会話はその場で通過させます。疑わしい兆候が残ったものだけを第2段階に渡し、詐欺会話でファインチューニングしたGemmaがより広い範囲の会話履歴を読み取って、脅威を確定するか誤検知として棄却します。
この構成はバッテリー消費を抑えるために選ばれたものです。すべてのメッセージに言語モデルを走らせれば端末の電力と処理時間を消費しますが、大半の会話は軽い処理で安全と判断できます。脅威が確定した場合は、機密情報や送金を渡す前に立ち止まるよう促す警告をリアルタイムで表示します。
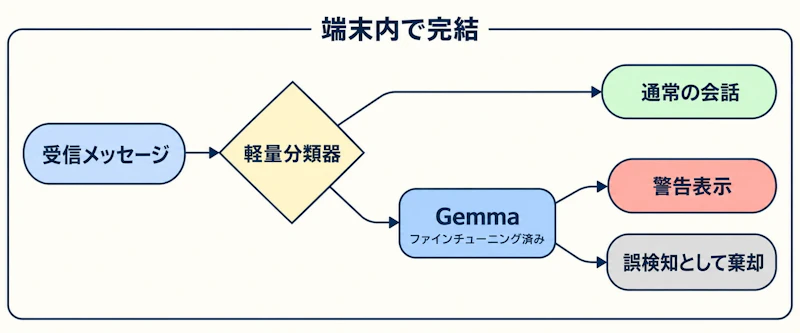
図1のように、判定はすべて端末の内部で完結します。Gemmaのような小型モデルを安価なハードウェア上で動かす手法はエッジ環境での分散推論の文脈でも検証が進んでおり、今回の設計もその延長線上にあります。
暗号化とプライバシーの両立
サーバー側でメッセージを走査する方式は、エンドツーエンド暗号化(E2EE)に対応したプラットフォームでは成立しません。通信事業者やプラットフォーム側が内容を読めないことが暗号化の前提だからです。端末内で推論を完結させる設計は、この制約を回避しつつ検知を成り立たせる手段になります。
GovTechのTrust and Safety担当ディレクターであるMark Chen氏は「詐欺との戦いが個人のプライバシーを犠牲にするものであってはならない」と述べています。利用者の会話がクラウドに送信されないため、保護と暗号化の両立を図る実装例として位置づけられています。
学習データのガバナンス
モデルの学習面でも管理の枠組みが設けられました。ファインチューニングはGovTechが管理するGoogle Cloud環境内で実施され、学習データを外部から隔離した状態で扱っています。
学習に用いたデータの扱いと検証は次の通りです。
- 市民の私的データや個人を特定できる情報は学習から除外
- 詐欺の通報記録や脅威インテリジェンスの匿名化データセットを使用
- 公的機関・銀行・地元の著名人を装う手口や地域で流行中の類型を学習
- 合成対話とローカルコーパスで、変化する詐称手法に対する耐性を検証
こうした隔離環境での学習と個人情報の排除は、公的機関がAIモデルを調達・運用する際のガバナンス設計として参考になります。
今後の展開
現時点で提供開始日や消費者向けアプリの計画は公表されていません。Google DeepMindは、メッセージングプラットフォームやOSベンダーがこうした軽量モデルを組み込むことで、利用者を端末側で保護できる可能性に言及しています。
なお、検知精度や誤検知率などの定量的な成績は公開されていません。会話型詐欺の検知は正常な会話を誤って警告するコストが大きい領域であり、実運用での精度は今後の判断材料になります。一方で、プライバシー制約が強い環境で言語モデルをどう配置するかという問いに対し、軽量分類器と小型LLMを組み合わせる構成は実装可能な選択肢の一つを示しています。


