 AI-Papers
- 周波数帯域を固定分割してきた従来の音源分離に対し、DBSは入力音声ごとに境界と帯域幅を動的に決める仕組みを提案
- 帯域トークン数を固定したまま境界を選ぶため計算量の予算を保てて、BSRNNやBS-RoFormerなど複数のバックボーンに後付けできる
- DnR v2で公開済みBSRNNに対し平均SI-SDRが相対29.0%改善、MUSDB18-HQとEchoSetでも一貫した向上を確認
研究の背景
音源分離は、複数の音が混ざった録音から音声、音楽、効果音といった成分を取り出す技術です。近年主流になっているのが帯域分割型(band-split)のアプローチで、音をスペクトログラム(時間と周波数の二次元表現)に変換したうえで、周波数軸をいくつかの帯域に区切り、帯域ごとに1つの特徴ベクトル(トークン)を作ってから分離ネットワークに渡します。
BSRNNをはじめとするこの系統の手法では、帯域の区切り位置があらかじめ人手で決められています。低域は細かく、高域は粗く分けるといった設計が経験的に使われてきましたが、どんな入力に対しても同じ境界が適用されます。
固定分割には2つの弱点があります。1つは、分けるべき成分が同じ帯域に押し込められてしまうこと。もう1つは、情報の乏しい周波数域にもトークンの予算を割いてしまうことです。清華大学の Bingzhe Zhang、Kai Li、Xiaolin Hu による論文「Learning Where to Split: Dynamic Band Splitting for Audio Source Separation」は、この境界そのものを学習対象にしました。
提案手法のしくみ
Dynamic Band Splitting(DBS)は、周波数軸をまず4つのブロックに大きく区切り、各ブロック内で「どこに境界を置くか」を入力の内容から予測します。隣り合う周波数ビンの間それぞれに境界スコアを付け、スコアの高い場所をhard Top-K(上位K個を選び取る操作)で選び出す構成です。
スコアの計算には、実部と虚部に対する畳み込みとBiLSTM(前後両方向を見る再帰ネットワーク)に加えて、ビンごとの平均、ピーク対平均比、標準偏差対平均比という3つのエネルギー統計量が使われます。音のスペクトルが急に変化する場所を手がかりに境界を置く設計です。
選ぶ境界の数はブロックごとに固定されているため、最終的な帯域トークン数は入力によらず一定に保たれます。DnR v2とMUSDB18-HQの設定では1025本のSTFTビンに対して4ブロック各32帯域、合計128トークン、EchoSetでは321ビンに対して合計67トークンという予算です。境界の位置だけが入力に応じて動くので、既存のバックボーンをそのまま流用できます。
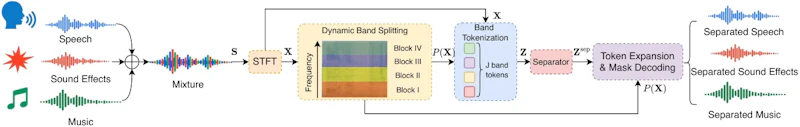
図2に示すように、各帯域内のビンは学習されたスコアによるsoftmax重み付けでまとめられ(内容依存プーリング)、1帯域1フレームあたり1トークンになります。分離後は境界確率を使ってトークンを滑らかにしてから元のSTFTグリッドへ展開し、周波数方向の残差ブロックで整えたうえで、周波数を共有するヘッドが複素マスクを出力します。
Top-Kのような離散的な選択は本来勾配が流れません。そこでstraight-through推定器(順伝播では離散値、逆伝播では連続値として扱う手法)で境界予測器まで勾配を戻し、さらに確信度を通す経路と、ソフトな境界密度を抑える比率損失を併用して学習を安定させています。
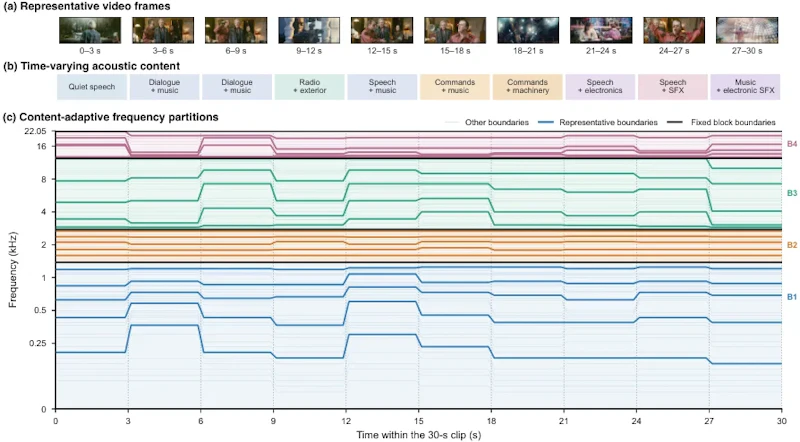
実際に学習された分割は入力ごとに異なります。図1では、3秒ごとの窓で支配的な音の種類が変わるのに合わせて境界の位置が移動しています。テスト64件すべてで異なる分割が選ばれ、隣接する窓の間でも境界は変化しました。同じ入力を再度推論すると同一の境界が得られるため、挙動は決定的です。
実験結果
評価は映画音響の分離(DnR v2)、音楽のステム分離(MUSDB18-HQ)、残響下の音声分離(EchoSet)の3つで行われました。帯域分割を置き換えるだけで済むため、BSRNN、TIGER、BS-RoFormer、MelRoFormerという4種類のバックボーンで比較されています。
データセット / バックボーン | 静的分割 | DBS | 差 |
|---|---|---|---|
DnR v2 平均SI-SDR / BSRNN(128帯域) | 7.69 dB | 9.07 dB | +1.38 dB |
DnR v2 平均SI-SDR / TIGER(128帯域) | 8.74 dB | 10.13 dB | +1.39 dB |
MUSDB18-HQ 平均SDR / BSRNN | 5.09 dB | 5.43 dB | +0.35 dB |
MUSDB18-HQ 平均SDR / BS-RoFormer | 4.50 dB | 6.34 dB | +1.84 dB |
MUSDB18-HQ 平均SDR / MelRoFormer | 7.25 dB | 8.07 dB | +0.82 dB |
DnR v2の内訳では、DBS-BSRNNが音楽6.48 dB、音声15.01 dB、効果音5.73 dBのSI-SDRを達成しました。見出しに出てくる相対29.0%という数字は、論文で報告されている既発表のBSRNN(7.03 dB)を基準にした値です。著者らが同条件で学習し直した128帯域の静的BSRNN(7.69 dB)と比べると相対17.9%の改善にあたるため、比較対象によって印象が変わる点は押さえておきたいところです。EchoSetでは既発表のBSRNNに対してSDRiが+0.46、TIGERに対して+0.33と、伸び幅は小さめでした。
構成要素の切り分け実験では、分割を均等幅にすると8.00 dB、メル尺度にすると5.87 dBまで下がり、学習可能なフィルタバンクに置き換えると分離が破綻しました。推論時に境界だけをBSRNNの固定配置へ差し替えると8.62 dBに落ちることから、学習された境界自体が性能に寄与していることがわかります。周波数方向の整え処理を外すと3.92 dB、スペクトル変化の事前情報を外すと4.09 dBと大きく劣化しており、境界の選択とその後の復元処理が噛み合って初めて機能する設計です。ブロック数は4が最良で、2だと8.32 dB、1だと6.30 dBでした。音声系の生成・処理モデルの動向はFish Audio Drama 3とは?演技指示に従う35B MoE音声生成モデルでも扱っています。
課題と今後の展望
限界も明示されています。帯域数とトークン予算は固定で、推論窓ごとに1つの分割しか選べません。著者らが試した帯域数そのものを学習する変種は、ブロックごとに許される最大の予算を選びがちだったため、可変予算を実現するには計算量への明示的な制約が必要だと述べられています。改善幅もデータセットによって差が大きく、MUSDB18-HQのBSRNNやEchoSetでは0.5 dB未満にとどまりました。
とはいえ、帯域分割というモジュールを差し替えるだけで複数のバックボーンに効果が出たことは、既存システムへの適用のしやすさを示しています。コードと音声デモはプロジェクトページで公開されており、自分の用途で効くかどうかを確かめやすい状態です。固定の信号処理的な前処理を学習可能な部品へ置き換える流れが、音声処理の入口の部分でも進んでいると言えます。
論文情報: "Learning Where to Split: Dynamic Band Splitting for Audio Source Separation"(Bingzhe Zhang, Kai Li, Xiaolin Hu, 2026) arXiv:2610.14993
本記事の図(図1〜図2)は解説のため上記論文より引用しています。


