 AI-Papers
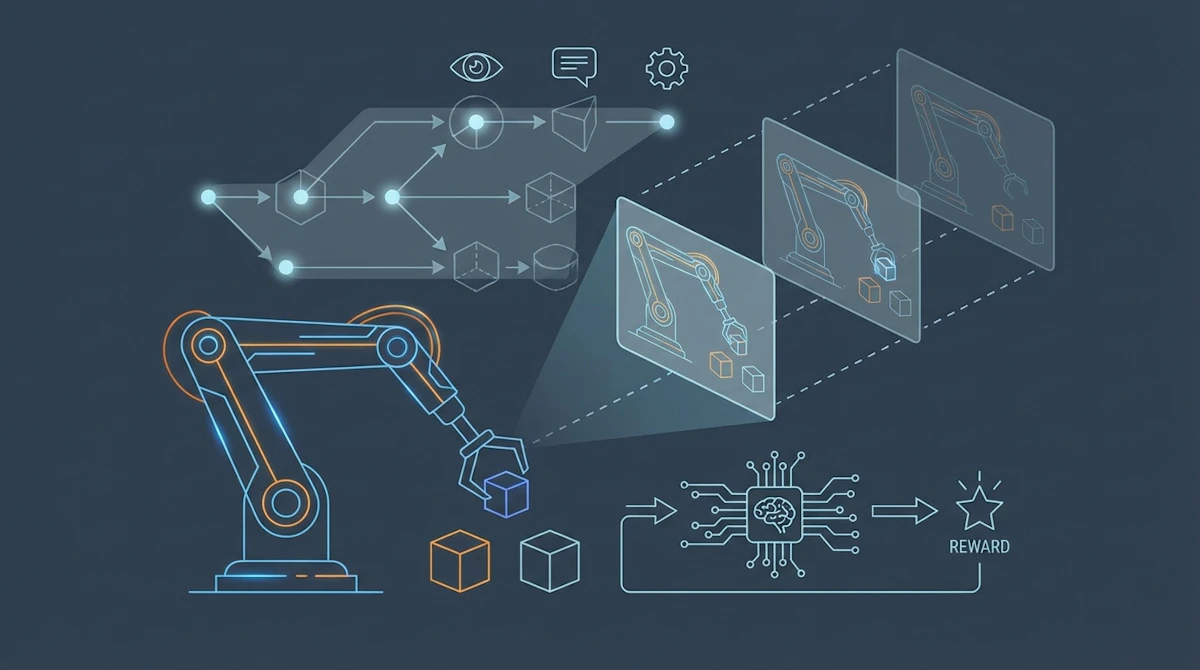
- World Modelベース強化学習(RAMP)により従来の模倣学習を30%上回る性能を実現
- 洗濯物の折りたたみや箱詰め作業など複雑な長期タスクで実環境での高い成功率を達成
- 1万時間以上のロボット操作データで事前学習され国際RoboChallengeベンチマークで首位を獲得
研究の背景
Vision-Language-Action(VLA)モデルは、視覚情報と言語指示からロボットの行動を直接予測する技術として注目されています。しかし従来の模倣学習アプローチには限界がありました。
人間のデモンストレーションデータから学習する手法では、訓練データに含まれない状況への対応が困難です。特にロボット制御では、予期しない環境変化や長期的な因果関係の理解が求められます。
GigaAIが発表したGigaBrain-0.5Mは、この課題をWorld Model(世界モデル、環境の状態変化を予測するモデル)ベースの強化学習で解決しました。大規模な映像データで事前学習された世界モデルを活用し、環境の時空間的な推論能力と将来予測能力を高めています。
提案手法:RAMPフレームワーク
本研究の中核となる技術がRAMP(Reinforcement leArning via world Model-conditioned Policy)です。世界モデルの予測を条件として強化学習を行うフレームワークになります。

従来の行動クローニング(Behavioral Cloning)では、デモンストレーションデータの入力に対する正解行動を模倣するだけでした。RAMPでは世界モデルが生成する将来の環境状態予測を活用し、より長期的な結果を考慮した意思決定が可能になります。
基盤モデルとなるGigaBrain-0.5は、1万時間を超えるロボット操作データで事前学習されています。この大規模学習により多様な操作パターンと環境ダイナミクスの知識を獲得しており、国際的なRoboChallengeベンチマークで第1位を記録しました。
世界モデルはウェブスケールの映像コーパスで事前学習されており、物理法則や物体の動きに関する豊富な知識を持っています。この知識がロボット制御の方策学習を効果的に導きます。
実験結果
GigaBrain-0.5MはRECAPベースラインと比較して約30%の性能向上を達成しました。特に複雑なタスクでの改善が目立ちます。
検証に用いられたのは、次のような長期の操作タスクです。
- 洗濯物の折りたたみ: 布の柔軟な変形を予測しながら複数ステップの操作を計画する
- 箱詰め作業: 物体の配置最適化と衝突回避を同時に行う
- エスプレッソ準備: 精密な動作シーケンスを順序どおりに実行する
いずれも長期的な因果関係が重要となるタスクであり、そこで世界モデルベースのアプローチが特に有効であることが示されました。実環境での検証でも、安定した長期実行と高いタスク完了率が確認されています。
従来手法では環境の予期しない変化に対応できず失敗するケースが多く見られました。一方GigaBrain-0.5Mは、世界モデルによる予測を活用して柔軟に行動を調整できます。この汎化能力の高さが、実用的なロボットシステムへの応用可能性を示しています。
まとめと今後の展望
GigaBrain-0.5Mは世界モデルベース強化学習によりVLAモデルの性能を大きく向上させました。従来の模倣学習の限界を超え、長期的な因果推論と環境適応能力を実現しています。
本研究の意義は、大規模映像データで学習された世界モデルがロボット制御に有効だと実証した点にあります。ウェブスケールの知識をロボティクスに転移する道筋を示しました。
今後は、さらに多様なタスクへの適用や複数ロボットの協調制御への拡張が期待されます。世界モデルの予測精度向上や計算効率の改善も残された研究課題です。Embodied AIの実用化に向けて、本手法は一つのマイルストーンとなります。


